
Identity
- Type
- university
- Country label
- USA
- HQ country
- USA
- Founding country
- USA
- Parent
- not in the notes
- Parent country
- not in the notes
- Country basis
- the research notes
Where this comes from
Convention D1: a dual label, HQ first, when the HQ, founding or parent country differ.
Models by Class
Models
ModelClassOpennessParametersReleased
 OWSM v4speech recognition16 Jan 2025OWSM-CTC v4 1Bspeech recognition16 Jan 2025MOMENT (MOMENT-1-large)time series6 Feb 2024
 Simple-BEVStanford University, Carnegie Mellon Universitydriving16 Jun 2022OC-SORTCarnegie Mellon University, Shanghai AI Lab, NVIDIAvision27 Mar 2022ConvMixerCarnegie Mellon University, Boschvision24 Jan 2022
 ECODNortheastern University, Carnegie Mellon Universitytabular2 Jan 2022
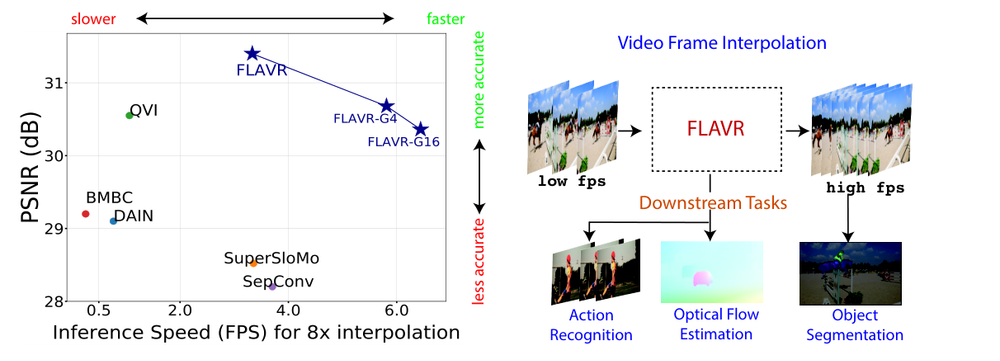
 FLAVRUC San Diego, Carnegie Mellon Universityvideo generation15 Dec 2020COPODNortheastern University, Carnegie Mellon Universitytabular20 Sep 2020
 XLNetGoogle, Carnegie Mellon Universitylanguage encoder19 Jun 2019Single-Path NASvision5 Apr 2019Transformer-XLGoogle, Carnegie Mellon UniversityLLM9 Jan 2019PyODtabular6 Jan 2019TCN (Temporal Convolutional Network)Carnegie Mellon University, Inteltime series4 Mar 2018Non-local Networks (video)Carnegie Mellon University, Metavision21 Nov 2017LSTNettime series21 Mar 2017OpenPosevision24 Nov 2016CPM (Convolutional Pose Machines)vision30 Jan 2016
Links
OrganisationCarnegie Mellon Universityuniversity, USA
Carnegie Mellon Universityuniversity, USA
Models 18
MOMENT (MOMENT-1-large)Carnegie Mellon University, time seriesDeveloperOC-SORTCarnegie Mellon University, Shanghai AI Lab, NVIDIA, visionDeveloperConvMixerCarnegie Mellon University, Bosch, visionDeveloperCOPODNortheastern University, Carnegie Mellon University, tabularDeveloperECODNortheastern University, Carnegie Mellon University, tabularDeveloperFLAVRUC San Diego, Carnegie Mellon University, video generationDeveloperNon-local Networks (video)Carnegie Mellon University, Meta, visionDeveloperOWSM v4Carnegie Mellon University, speech recognitionDeveloperOWSM-CTC v4 1BCarnegie Mellon University, speech recognitionDeveloperSimple-BEVStanford University, Carnegie Mellon University, drivingDeveloperTCN (Temporal Convolutional Network)Carnegie Mellon University, Intel, time seriesDeveloperTransformer-XLGoogle, Carnegie Mellon University, LLMDeveloper+6
XLNetGoogle, Carnegie Mellon University, language encoderDeveloperCPM (Convolutional Pose Machines)Carnegie Mellon University, visionDeveloperLSTNetCarnegie Mellon University, time seriesDeveloperOpenPoseCarnegie Mellon University, visionDeveloperPyODCarnegie Mellon University, tabularDeveloperSingle-Path NASCarnegie Mellon University, visionDeveloperScores
| Benchmark | Model | Score | Who ran it | Setting |
|---|---|---|---|---|
| TSB-AD | MOMENT (MOMENT-1-large) | 0.39 VUS-PR | independent | Univariate, fine-tuned (FT); as reported in the PaAno paper |
Where this comes from
Every recorded score of this organisation's models, with who ran it. Scores from different settings are not directly comparable.
Sources
- MOMENT: A Family of Open Time-series Foundation Models arxiv.org https://arxiv.org/html/2402.03885v3
- AutonLab/MOMENT-1-large , Hugging Face huggingface.co https://huggingface.co/AutonLab/MOMENT-1-large
To cite this page: Project AURION, AI Use-Cases Research & Innovation, "Carnegie Mellon University", https://aurion.semai.id/organisations/carnegie-mellon-university/, records of October 2026.