
Identity
- Type
- big tech
- Country label
- USA
- HQ country
- USA
- Founding country
- USA
- Parent
- not in the notes
- Parent country
- not in the notes
- Country basis
- the research notes
Where this comes from
Convention D1: a dual label, HQ first, when the HQ, founding or parent country differ.
Models by Class
Models
ModelClassOpennessParametersReleased
 Muse Spark 1.3multimodal LLM2 Sep 2026Muse Glimmer 30Bmultimodal LLM10 Aug 2026Muse Spark 1.1LLM9 Jul 2026Muse Videovideo generation7 Jul 2026Muse Imageimage generationJul 2026Sapiens2vision23 Apr 2026Muse SparkLLM8 Apr 2026SAM 3.1 (Object Multiplex)vision27 Mar 2026EUPE (Efficient Universal Perception Encoder)vision23 Mar 2026SAM Audiomusic and audio12 Dec 2025Omnilingual ASRspeech recognition10 Nov 2025SAM 3visionNov 2025
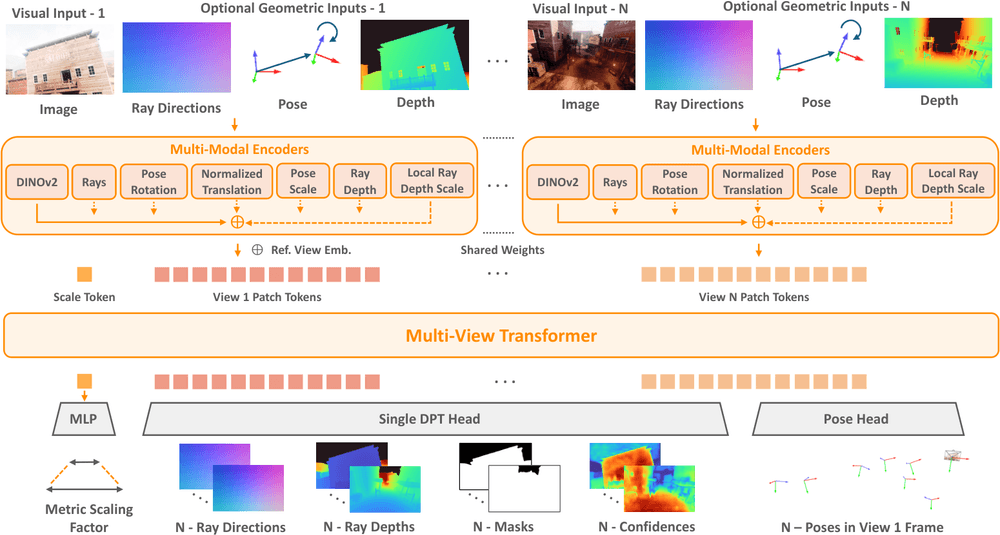 MapAnything3D8 Sep 2025DINOv3vision13 Aug 2025DINOv3 ConvNeXt-Bvision13 Aug 2025DINOv3 ConvNeXt-Lvision13 Aug 2025DINOv3 ConvNeXt-Svision13 Aug 2025DINOv3 ConvNeXt-Tvision13 Aug 2025DINOv3 ViT-7Bvision13 Aug 2025DINOv3 ViT-Bvision13 Aug 2025DINOv3 ViT-H+vision13 Aug 2025DINOv3 ViT-Lvision13 Aug 2025DINOv3 ViT-Svision13 Aug 2025DINOv3 ViT-S+vision13 Aug 2025DINOv3 SAT-493M ViT-7BgeospatialAug 2025DINOv3 SAT-493M ViT-L (distilled)geospatialAug 2025MetaCLIP 2 (worldwide, ViT-H)embedding31 Jul 2025V-JEPA 2world model11 Jun 2025V-JEPA 2-ACrobot policy11 Jun 2025Perception Encoderembedding11 Apr 2025PE-Core-L14-336embedding11 Apr 2025PE-Core-G14-448embedding11 Apr 2025Llama 4LLMApr 2025Llama 4 Maverickmultimodal LLMApr 2025Llama 4 Scoutmultimodal LLMApr 2025Llama Guard 4 12BguardApr 2025Llama Prompt Guard 2 22MguardApr 2025Llama Prompt Guard 2 86MguardApr 2025Prompt-Guard-86MguardApr 2025eSEN-30M-OAMmaterials17 Mar 2025
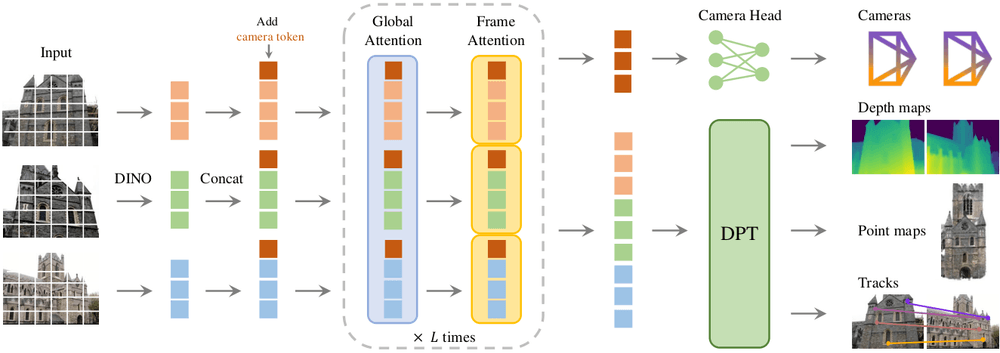 VGGT3D11 Mar 2025Audiobox Aestheticsaudio classification7 Feb 2025EdgeTAMvision13 Jan 2025Llama-3.3-70B-InstructLLM26 Nov 2024MobileLLM 1Bedge LLM31 Oct 2024MobileLLM 125Medge LLM30 Oct 2024Llama 3.2LLM24 Oct 2024Llama 3.2 1Bedge LLM24 Oct 2024Llama 3.2 3Bedge LLM24 Oct 2024LongVUMeta, King Abdullah University of Science and Technologymultimodal LLM18 Oct 2024Sapiensvision22 Aug 2024Llama-3.1-8B-InstructLLM18 Jul 2024HSTU (Generative Recommenders)recommendation27 Feb 2024MobileLLMedge LLM22 Feb 2024MAGNeTmusic and audio9 Jan 2024w2v-bert-2.0speech recognition19 Dec 2023Llama GuardguardDec 2023SeamlessM4T v2 largetranslation30 Nov 2023
 Dobb-ENew York University, Metarobot policy27 Nov 2023NougatOCR and document25 Aug 2023Code Llamacode24 Aug 2023SeamlessM4Ttranslation22 Aug 2023DINOv2vision17 Jul 2023mms-1b-allspeech recognition27 May 2023ImageBindembedding9 May 2023I-JEPAvision19 Jan 2023ConvNeXt V2vision2 Jan 2023MusicGenmusic and audio2023
 HorNetTsinghua University, Metavision28 Jul 2022NLLB-200translation8 Jul 2022NLLB-200 distilled 600Mtranslation8 Jul 2022NLLB-200 distilled 1.3Btranslation8 Jul 2022NLLB-200 3.3Btranslation8 Jul 2022OPT 66BLLM23 Jun 2022OPT 125MLLM11 May 2022OPT 1.3BLLM11 May 2022OPT 6.7BLLM11 May 2022OPTLLM2 May 2022DeiT IIIvision14 Apr 2022ViTDetvision30 Mar 2022data2vec visionvision7 Feb 2022ConvNeXtvision10 Jan 2022ConvNeXtvision10 Jan 2022Deticvision7 Jan 2022Mask2Formervision2 Dec 2021MAE (Masked Autoencoder)vision11 Nov 2021MaskFormervision13 Jul 2021XCiTvision17 Jun 2021HuBERTspeech recognition14 Jun 2021hubert-base-ls960speech recognition14 Jun 2021hubert-large-ll60kspeech recognition14 Jun 2021hubert-xlarge-ll60kspeech recognition14 Jun 2021DINO (v1)vision29 Apr 2021MViT (Multiscale Vision Transformers)vision22 Apr 2021LeViTvision2 Apr 2021CaiTvision31 Mar 2021
 ConViTEcole Normale Superieure (Paris), Metavision19 Mar 2021RegNetZvision11 Mar 2021Barlow TwinsMeta, New York Universityvision4 Mar 2021D2Govision12 Feb 2021TimeSformervision9 Feb 2021DeiTvision23 Dec 2020DeiT-B distilledvision23 Dec 2020DeiT-Tivision23 Dec 2020
 InterNet (InterHand2.6M)Seoul National University, Metavision21 Aug 2020
 SwAVINRIA, Metavision17 Jun 2020DETRvision26 May 2020DETR ResNet-50vision26 May 2020DETR ResNet-101vision26 May 2020DETR ResNet-50 panopticvision26 May 2020ResNeStMeta, Amazonvision19 Apr 2020X3Dvision9 Apr 2020RegNetvision30 Mar 2020ImVoteNetMeta, Stanford Universityvision29 Jan 2020PointRendvision17 Dec 2019MoCovision13 Nov 2019XLM-RoBERTalanguage encoder5 Nov 2019BARTLLM29 Oct 2019Detectron2 model zoovision5 Sep 2019RoBERTalanguage encoder26 Jul 2019
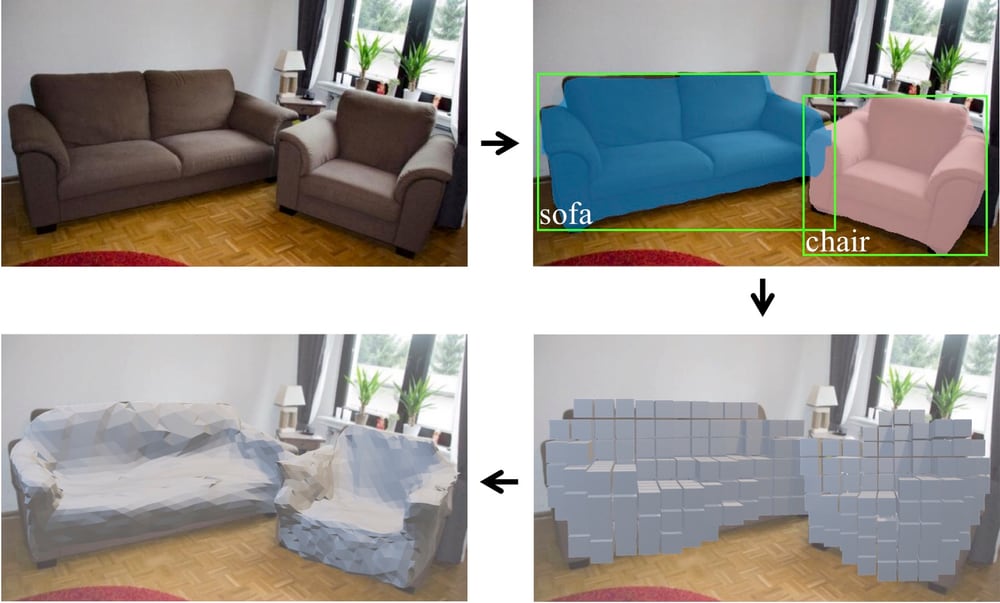 Mesh R-CNN3D6 Jun 2019DLRM (Deep Learning Recommendation Model)recommendation31 May 2019VoteNetvision21 Apr 2019CSNvision4 Apr 2019TensorMaskvision28 Mar 2019Panoptic FPNvision8 Jan 2019LASERembedding26 Dec 2018
 LFB (Long-Term Feature Bank)University of Texas at Austin, Metavision12 Dec 2018SlowFastvision10 Dec 2018
 VideoPose3DETH Zurich, Metavision28 Nov 2018ResNeXt-101 32x8d WSLvision2 May 2018DensePosevision1 Feb 2018
 Non-local Networks (video)Carnegie Mellon University, Metavision21 Nov 2017RetinaNetvision7 Aug 2017Mask R-CNNvision20 Mar 2017Keypoint R-CNNvision20 Mar 2017
 ResNeXtUC San Diego, Metavision16 Nov 2016ResNeXt-50 32x4dUC San Diego, Metavision16 Nov 2016
 DenseNetCornell University, Tsinghua University, Metavision25 Aug 2016fastText word vectorsembedding15 Jul 2016
 DCGANindico, Metaimage generation19 Nov 2015C3DMeta, Dartmouth Collegevision2 Dec 2014ESM-2 / ESMFoldscientific–Llama 2LLM–Llama 2 70BLLM–Llama-2-7BLLM–Llama 3.1 405BLLM–Llama-3.1-405B-InstructLLM–Llama 3.1 70BLLM–Llama 3.1 70B InstructLLM–Llama 3.1 8BLLM–Llama-3.2-1B-InstructLLM–Llama 3.2 1B quantized (QLoRA)edge LLM–Llama 3.2 1B quantized (SpinQuant)edge LLM–Llama 3.2 3B quantized (QLoRA)edge LLM–Llama 3.2 3B quantized (SpinQuant)edge LLM–Llama3-70B InstructLLM–Llama 3 8BLLM–Meta-Llama-3-8B-InstructLLM–MMSspeech recognition–Muse GlimmerLLM–Muse Spark 1.2LLM–Muse Spark (family)LLM–Prophettime series–SAM 1vision–SAM 2vision–SAM 3D Objects3D–V-JEPAworld model–wav2vec 2.0speech recognition–wav2vec2-large-xlsr-53speech recognition–Sparshrobot policy–RoBERTa baselanguage encoder–RoBERTa largelanguage encoder–XLM-RoBERTa baselanguage encoder–XLM-RoBERTa largelanguage encoder–BART largeLLM–BART large CNNLLM–BART large MNLIlanguage encoder–mBART-50 many-to-manytranslation–Code Llama 7Bcode–Code Llama 13B Instructcode–Code Llama 34B Pythoncode–Code Llama 70B Instructcode–VoteNetvision–
Links
OrganisationMetabig tech, USA
Metabig tech, USA

Models 184
DINOv3Meta, visionDeveloperDINOv3 ViT-7BMeta, visionDeveloperLlama 3.2Meta, LLMDeveloperLlama 3 8BMeta, LLMDeveloperMMSMeta, speech recognitionDeveloperLlama 3.2 1BMeta, edge LLMDeveloperBARTMeta, LLMDeveloperCode LlamaMeta, codeDeveloperDINOv2Meta, visionDeveloperLlama 3.2 3BMeta, edge LLMDeveloperMuse Spark (family)Meta, LLMDeveloperMuse Spark 1.1Meta, LLMDeveloper+172
OPTMeta, LLMDeveloperSAM 3Meta, visionDeveloperDeiTMeta, visionDeveloperDETRMeta, visionDeveloperDINOv3 ConvNeXt-BMeta, visionDeveloperDINOv3 ConvNeXt-LMeta, visionDeveloperDINOv3 ConvNeXt-SMeta, visionDeveloperDINOv3 ConvNeXt-TMeta, visionDeveloperHuBERTMeta, speech recognitionDeveloperLlama 3.1 70BMeta, LLMDeveloperLlama 3.2 1B quantized (QLoRA)Meta, edge LLMDeveloperLlama 3.2 1B quantized (SpinQuant)Meta, edge LLMDeveloperLlama 3.2 3B quantized (QLoRA)Meta, edge LLMDeveloperLlama 3.2 3B quantized (SpinQuant)Meta, edge LLMDeveloperLlama 4Meta, LLMDeveloperLlama 4 ScoutMeta, multimodal LLMDeveloperLlama-2-7BMeta, LLMDeveloperLlama-3.3-70B-InstructMeta, LLMDeveloperMobileLLMMeta, edge LLMDeveloperMuse Spark 1.2Meta, LLMDeveloperNLLB-200Meta, translationDeveloperResNeXtUC San Diego, Meta, visionDeveloperSapiensMeta, visionDeveloperSapiens2Meta, visionDeveloperConvNeXtMeta, visionDeveloperConvNeXtMeta, visionDeveloperConvNeXt V2Meta, visionDeveloperDeiT IIIMeta, visionDeveloperDeiT-B distilledMeta, visionDeveloperDenseNetCornell University, Tsinghua University, Meta, visionDeveloperDETR ResNet-50 panopticMeta, visionDeveloperDINOv3 SAT-493M ViT-7BMeta, geospatialDeveloperDINOv3 SAT-493M ViT-L (distilled)Meta, geospatialDeveloperDINOv3 ViT-BMeta, visionDeveloperDINOv3 ViT-H+Meta, visionDeveloperDINOv3 ViT-LMeta, visionDeveloperDINOv3 ViT-SMeta, visionDeveloperDINOv3 ViT-S+Meta, visionDeveloperEdgeTAMMeta, visionDeveloperESM-2 / ESMFoldMeta, scientificDeveloperImVoteNetMeta, Stanford University, visionDeveloperInterNet (InterHand2.6M)Seoul National University, Meta, visionDeveloperLlama 2Meta, LLMDeveloperLlama 3.1 70B InstructMeta, LLMDeveloperLlama 3.1 8BMeta, LLMDeveloperLlama 4 MaverickMeta, multimodal LLMDeveloperLlama-3.2-1B-InstructMeta, LLMDeveloperLlama3-70B InstructMeta, LLMDeveloperMobileLLM 125MMeta, edge LLMDeveloperMobileLLM 1BMeta, edge LLMDeveloperMuse SparkMeta, LLMDeveloperMuse Spark 1.3Meta, multimodal LLMDeveloperNLLB-200 distilled 600MMeta, translationDeveloperOmnilingual ASRMeta, speech recognitionDeveloperPerception EncoderMeta, embeddingDeveloperResNeXt-50 32x4dUC San Diego, Meta, visionDeveloperRoBERTaMeta, language encoderDeveloperSAM 2Meta, visionDeveloperSAM 3.1 (Object Multiplex)Meta, visionDeveloperSeamlessM4TMeta, translationDeveloperV-JEPAMeta, world modelDeveloperV-JEPA 2Meta, world modelDeveloperV-JEPA 2-ACMeta, robot policyDeveloperVoteNetMeta, visionDeveloperXLM-RoBERTaMeta, language encoderDeveloperBarlow TwinsMeta, New York University, visionDeveloperBART largeMeta, LLMDeveloperBART large CNNMeta, LLMDeveloperBART large MNLIMeta, language encoderDeveloperC3DMeta, Dartmouth College, visionDeveloperCode Llama 13B InstructMeta, codeDeveloperCode Llama 34B PythonMeta, codeDeveloperCode Llama 70B InstructMeta, codeDeveloperCode Llama 7BMeta, codeDeveloperConViTEcole Normale Superieure (Paris), Meta, visionDeveloperDCGANindico, Meta, image generationDeveloperDeiT-TiMeta, visionDeveloperDETR ResNet-101Meta, visionDeveloperDETR ResNet-50Meta, visionDeveloperDINO (v1)Meta, visionDeveloperDobb-ENew York University, Meta, robot policyDeveloperfastText word vectorsMeta, embeddingDeveloperHorNetTsinghua University, Meta, visionDeveloperHSTU (Generative Recommenders)Meta, recommendationDeveloperhubert-base-ls960Meta, speech recognitionDeveloperhubert-large-ll60kMeta, speech recognitionDeveloperhubert-xlarge-ll60kMeta, speech recognitionDeveloperImageBindMeta, embeddingDeveloperKeypoint R-CNNMeta, visionDeveloperLASERMeta, embeddingDeveloperLFB (Long-Term Feature Bank)University of Texas at Austin, Meta, visionDeveloperLlama GuardMeta, guardDeveloperLlama Guard 4 12BMeta, guardDeveloperLlama-3.1-405B-InstructMeta, LLMDeveloperLlama-3.1-8B-InstructMeta, LLMDeveloperLongVUMeta, King Abdullah University of Science and Technology, multimodal LLMDeveloperMask R-CNNMeta, visionDeveloperMeta-Llama-3-8B-InstructMeta, LLMDevelopermms-1b-allMeta, speech recognitionDeveloperMuse Glimmer 30BMeta, multimodal LLMDeveloperMViT (Multiscale Vision Transformers)Meta, visionDeveloperNLLB-200 3.3BMeta, translationDeveloperNLLB-200 distilled 1.3BMeta, translationDeveloperNon-local Networks (video)Carnegie Mellon University, Meta, visionDeveloperOPT 1.3BMeta, LLMDeveloperOPT 125MMeta, LLMDeveloperOPT 6.7BMeta, LLMDeveloperOPT 66BMeta, LLMDeveloperPE-Core-G14-448Meta, embeddingDeveloperPE-Core-L14-336Meta, embeddingDeveloperRegNetMeta, visionDeveloperRegNetZMeta, visionDeveloperResNeStMeta, Amazon, visionDeveloperResNeXt-101 32x8d WSLMeta, visionDeveloperRoBERTa baseMeta, language encoderDeveloperRoBERTa largeMeta, language encoderDeveloperSAM 1Meta, visionDeveloperSAM 3D ObjectsMeta, 3DDeveloperSeamlessM4T v2 largeMeta, translationDeveloperSwAVINRIA, Meta, visionDeveloperVideoPose3DETH Zurich, Meta, visionDeveloperVoteNetMeta, visionDeveloperwav2vec 2.0Meta, speech recognitionDeveloperwav2vec2-large-xlsr-53Meta, speech recognitionDeveloperX3DMeta, visionDeveloperXLM-RoBERTa baseMeta, language encoderDeveloperXLM-RoBERTa largeMeta, language encoderDeveloperAudiobox AestheticsMeta, audio classificationDeveloperCaiTMeta, visionDeveloperCSNMeta, visionDeveloperD2GoMeta, visionDeveloperdata2vec visionMeta, visionDeveloperDensePoseMeta, visionDeveloperDetectron2 model zooMeta, visionDeveloperDeticMeta, visionDeveloperDLRM (Deep Learning Recommendation Model)Meta, recommendationDevelopereSEN-30M-OAMMeta, materialsDeveloperEUPE (Efficient Universal Perception Encoder)Meta, visionDeveloperI-JEPAMeta, visionDeveloperLeViTMeta, visionDeveloperLlama 2 70BMeta, LLMDeveloperLlama 3.1 405BMeta, LLMDeveloperLlama Prompt Guard 2 22MMeta, guardDeveloperLlama Prompt Guard 2 86MMeta, guardDeveloperMAE (Masked Autoencoder)Meta, visionDeveloperMAGNeTMeta, music and audioDeveloperMapAnythingMeta, 3DDeveloperMask2FormerMeta, visionDeveloperMaskFormerMeta, visionDevelopermBART-50 many-to-manyMeta, translationDeveloperMesh R-CNNMeta, 3DDeveloperMetaCLIP 2 (worldwide, ViT-H)Meta, embeddingDeveloperMoCoMeta, visionDeveloperMuse GlimmerMeta, LLMDeveloperMuse ImageMeta, image generationDeveloperMuse VideoMeta, video generationDeveloperMusicGenMeta, music and audioDeveloperNougatMeta, OCR and documentDeveloperPanoptic FPNMeta, visionDeveloperPointRendMeta, visionDeveloperPrompt-Guard-86MMeta, guardDeveloperProphetMeta, time seriesDeveloperRetinaNetMeta, visionDeveloperSAM AudioMeta, music and audioDeveloperSlowFastMeta, visionDeveloperSparshMeta, robot policyDeveloperTensorMaskMeta, visionDeveloperTimeSformerMeta, visionDeveloperVGGTMeta, 3DDeveloperViTDetMeta, visionDeveloperw2v-bert-2.0Meta, speech recognitionDeveloperXCiTMeta, visionDeveloperScores
| Benchmark | Model | Score | Who ran it | Setting |
|---|---|---|---|---|
| Arena Text leaderboard | Muse Spark 1.3 | 1,494 Elo | independent | max |
| Arena Vision leaderboard | Muse Spark | 1,294 Elo | independent | muse-spark |
| Arena Vision leaderboard | Muse Spark 1.1 | 1,280 Elo | independent | |
| Arena Vision leaderboard | Muse Spark 1.2 | 1,293 Elo | independent | xHigh |
| Arena Vision leaderboard | Muse Spark 1.3 | 1,286 Elo | independent | xHigh |
| Arena Vision leaderboard | Muse Spark 1.3 | 1,290 Elo | independent | max (muse-spark-1.3-max) |
| Artificial Analysis Intelligence Index | Muse Spark 1.3 | 48 index | independent | max |
| Artificial Analysis Intelligence Index | Muse Spark 1.3 | 48 index | independent | max |
| Artificial Analysis Music Arena | MusicGen | 881 Elo | independent | secondary capture of AA post; lowest reported |
| Artificial Analysis Text-to-Image Arena | Muse Image | 1,116 Elo | independent | rank shown as 8-10 |
| Common Voice 22 (CV22-76) | Omnilingual ASR | 6.4 CER | vendor-reported | 7B LLM-ASR, CV22-76, approximate |
| Epic-Kitchens-100 action anticipation | V-JEPA 2 | 39.7 R@5 | vendor-reported | anticipation |
| FLEURS | Omnilingual ASR | 6.2 CER | vendor-reported | 7B LLM-ASR, FLEURS-102, approximate |
| IDSV (Indonesian Speech Variability) | mms-1b-all | 29.3 WER | independent | IDSV test, all, zero-shot |
| IDSV (Indonesian Speech Variability) | mms-1b-all | 9.57 CER | independent | IDSV test, all, zero-shot |
| LMArena Text-to-Image Arena | Muse Image | 1,274 Elo | independent | |
| LMArena Text-to-Video Arena | Muse Video | 1,456 Elo | independent | |
| LVIS | SAM 3 | 37.2 cgF1 | vendor-reported | instance segmentation |
| LVIS | SAM 3 | 40.6 cgF1 | vendor-reported | box |
| LVIS | SAM 3 | 48.5 AP | vendor-reported | instance segmentation |
| Matbench Discovery | eSEN-30M-OAM | 0.17 kSRME | maintainer-run | lower is better |
| Matbench Discovery | eSEN-30M-OAM | 0.888 CPS | maintainer-run | |
| Matbench Discovery | eSEN-30M-OAM | 0.925 F1 | maintainer-run | |
| MCP Atlas | Muse Glimmer 30B | 75.5 % | vendor-reported | |
| PerceptionTest | V-JEPA 2 | 84 % | vendor-reported | 8B LLM-aligned scale |
| SA-Co/Gold | SAM 3 | 54.1 cgF1 | vendor-reported | human 72.8 |
| SA-V | SAM 3 | 30.3 cgF1 | vendor-reported | test; human 53.1 |
| SEA-HELM | Llama 4 Scout | 63.43 score | maintainer-run | Checkpoint Llama-4-Scout-17B-16E-Instruct as listed; release view (data last updated 18 Sep 2026); score is the average of 2000 bootstraps |
| SEA-HELM | Llama 4 Scout | 67.86 score | maintainer-run | Checkpoint Llama-4-Scout-17B-16E-Instruct as listed; release view (data last updated 18 Sep 2026); score is the average of 2000 bootstraps |
| SEA-HELM | Llama-3.1-8B-Instruct | 37.2 score | maintainer-run | Checkpoint Llama-3.1-8B-Instruct as listed; release view (data last updated 18 Sep 2026); score is the average of 2000 bootstraps |
| SEA-HELM | Llama-3.1-8B-Instruct | 54.48 score | maintainer-run | Checkpoint Llama-3.1-8B-Instruct as listed; release view (data last updated 18 Sep 2026); score is the average of 2000 bootstraps |
| SEA-HELM | Llama-3.3-70B-Instruct | 60.44 score | maintainer-run | Checkpoint Llama-3.3-70B-Instruct as listed; release view (data last updated 18 Sep 2026); score is the average of 2000 bootstraps |
| SEA-HELM | Llama-3.3-70B-Instruct | 71.37 score | maintainer-run | Checkpoint Llama-3.3-70B-Instruct as listed; release view (data last updated 18 Sep 2026); score is the average of 2000 bootstraps |
| SEA-HELM | Muse Glimmer 30B | 72.13 score | maintainer-run | |
| SEA-HELM | Muse Glimmer 30B | 75.61 score | maintainer-run | |
| Something-Something v2 | V-JEPA 2 | 77.3 % top-1 | vendor-reported | |
| SWE-bench Pro | Muse Spark 1.1 | 61.5 % | maintainer-run | Scale SEAL public, mini-swe-agent, +/-3.10 |
| SWE-bench Verified | Muse Glimmer 30B | 76 % | vendor-reported | |
| TempCompass | V-JEPA 2 | 76.9 % | vendor-reported | 8B LLM-aligned scale |
Where this comes from
Every recorded score of this organisation's models, with who ran it. Scores from different settings are not directly comparable.
Sources
- AI at Meta Blog ai.meta.com https://ai.meta.com/blog/
- Muse Spark 1.3 (max) - Intelligence, Performance & Price Analysis | Artificial Analysis artificialanalysis.ai https://artificialanalysis.ai/models/muse-spark-1-3
- huggingface.co/meta-models https://huggingface.co/meta-models
- huggingface.co/meta-llama https://huggingface.co/meta-llama
- GitHub - facebookresearch/sam3: The repository provides code for running inference and finetuning with the Meta Segment Anything Model 3 (SA github.com https://github.com/facebookresearch/sam3
- huggingface.co/facebook/dinov3-vit7b16-pretrain-sat493m https://huggingface.co/facebook/dinov3-vit7b16-pretrain-sat493m
- Meta Superintelligence Labs - Wikipedia en.wikipedia.org https://en.wikipedia.org/wiki/Meta_Superintelligence_Labs
- Introducing quantized Llama models with increased speed and a reduced memory footprint ai.meta.com https://ai.meta.com/blog/meta-llama-quantized-lightweight-models/
- GitHub - pytorch/executorch: On-device AI across mobile, embedded and edge for PyTorch github.com https://github.com/pytorch/executorch
- Indonesia Tech Leaders Team With NVIDIA and Partners to Launch Nation’s AI blogs.nvidia.com https://blogs.nvidia.com/?p=75648
- Training compute of frontier AI models grows by 4-5x per year epoch.ai https://epoch.ai/blog/training-compute-of-frontier-ai-models-grows-by-4-5x-per-year
- Over 30 AI models have been trained at the scale of GPT-4 epoch.ai https://epoch.ai/data-insights/models-over-1e25-flop
- Llama Guard: LLM-based Input-Output Safeguard for Human-AI Conversations arxiv.org https://arxiv.org/abs/2312.06674
- Introducing the V-JEPA 2 world model and new benchmarks for physical reasoning ai.meta.com https://ai.meta.com/blog/v-jepa-2-world-model-benchmarks/
To cite this page: Project AURION, AI Use-Cases Research & Innovation, "Meta", https://aurion.semai.id/organisations/meta/, records of October 2026.